Math for ML
ML 中常用的数学:向量内积与外积(以及外积与线性注意力的关系)、按行和按列理解矩阵乘法、L1/L2 范数与 KL 散度。
- Doc no.
- KKZ-TN-142
- Date
- 2026-03-18
- GMT day
- 2026:077
- Est. read
- 8 min
01向量内积#
1.1物理意义#
内积本质上是一个向量在另一个向量方向上的投影长度,与基准向量长度的乘积。
- 如果提取特征或求取分量,令 为单位向量(),则 直接输出 在 方向上的标量投影。
- 工程应用: 在信号处理(如傅里叶变换)中,信号与正交基函数的内积,就是在提取该信号在特定频率上的能量分量。在经典力学中,功的计算 就是提取力在位移方向上的有效分量并相乘。
由于内积公式中包含 ,它是衡量高维空间中两个向量方向“一致性”或“对齐程度”的线性算子。
- 当 时,夹角为锐角,两者存在正相关性。
- 当 时,,两向量正交(垂直)。在工程上,这意味着两个系统、信号或特征完全独立,互不干涉(即协方差为零)。
- 当 时,夹角为钝角,存在负相关性。
- 工程应用: 在机器学习和数据挖掘中,将向量归一化后求内积,即为余弦相似度(Cosine Similarity),常用于衡量文本词向量的语义相似性或推荐系统中用户偏好的匹配度。
02向量外积#
假设有两个列向量 和 ,它们的外积定义为
它的数学与物理意义主要体现在以下两个方面:
2.1秩 1 矩阵#
外积 生成的矩阵,其秩(Rank)永远为 1。这意味着矩阵中的每一列都是 的线性变换(按 的元素缩放),每一行都是 的线性变换。
在矩阵分解理论(如奇异值分解 SVD)中,任何一个复杂的 矩阵都可以被拆解为多个相互正交的秩1矩阵之和(即多个外积之和)。因此,外积是构建任何复杂线性变换矩阵的原子操作。
2.2联想记忆与投影算子#
从算子(Operator)视角看,外积构成了一个有向的映射规则。假设我们用矩阵 去乘一个新向量 :
这里发生了一个非常清晰的工程操作:
- 是一个标量(内积),计算的是输入 与 相似度(或在 方向上的投影)。
- 然后将这个标量结果作为权重,去缩放向量 。
- 工程结论: 外积 本质上编码了一条规则——“当输入中包含 的成分时,输出相应的 的成分”。这在神经网络中被称为**联想记忆(Associative Memory)**的数学基础。
2.3线性注意力中的外积#
线性注意力(Linear Attention)通过去掉 Softmax(或用核函数特征映射 替代),利用矩阵乘法的结合律将公式改写为:
在这个公式中, 的本质就是一系列键值向量的外积之和。假设序列中有 个 token,第 个 token 的键和值分别是列向量 和 ,那么:
累加操作本身保证了全局上下文的感知(没有遗漏),但受限于特征维度 的硬性天花板,它牺牲了局部信息的绝对精确解析度(发生了有损压缩)
在这里, 和 使用外积的根本原因如下:
状态压缩(State Compression)
每一个 都是一个 的秩1矩阵。它将第 个 token 的 (条件/触发器)和 (内容/载荷)绑定在一起,形成了一个局部的映射规则。通过对整个序列的 个外积求和(),系统将长度为 的序列信息,物理压缩成了一个固定尺寸的 的状态矩阵 。此时,显存占用从与序列长度相关的 下降为固定的 。
延迟查询的解析(Resolving the Deferred Query)
在这个压缩后的系统状态 准备好之后,当一个新的查询特征向量 试图获取信息时,由于矩阵乘法的线性性质:
此时,数学逻辑完美闭环:查询向量 首先与状态矩阵中隐含的每一个 进行内积(),得到标量相似度,然后再用这个相似度去线性组合对应的 。
2.4例子#
为了清晰、直观地展示这个过程,我们设定一个序列长度 的极简环境。假设特征维度 ,值维度 。我们设定以下具体的列向量(你可以把它们想象成神经网络中经过线性层输出的具体的特征数值):
查询向量(Query):
键向量(Keys)与值向量(Values):
- 第 1 个 token:,
- 第 2 个 token:,
- 第 3 个 token:,
下面我们分别用**“先构建状态矩阵 ”(等式左边)和“先计算注意力权重”**(等式右边)两种路径来推演,验证它们为何结果完全一致。
左边:#
这一步的核心是:先不考虑查询 ,直接把序列中所有的 和 压缩成一个系统状态矩阵 。
第一步:计算每个 token 的外积()。
这是一个列向量乘以行向量,结果是一个 的矩阵:
第二步:求和得到状态矩阵 。
将这三个 矩阵直接相加,实现了信息的物理叠加压缩:
$$ S = \sum_{i=1}^{3} k_i v_i^T = \begin{bmatrix} 1 & 1 \ 0 & 0 \end{bmatrix}
- \begin{bmatrix} 0 & 0 \ 2 & 0 \end{bmatrix}
- \begin{bmatrix} 0 & 2 \ 0 & 2 \end{bmatrix} = \begin{bmatrix} 1 & 3 \ 2 & 2 \end{bmatrix} $$
此时,3 个 token 的全部信息已经被压缩到了这个固定的 矩阵中。
第三步:用 查询矩阵 。
将行向量 乘以矩阵 :
右边:#
这一步的核心是:不构建中间矩阵 ,而是让查询 逐一去和每一个 计算相似度,再用相似度去加权对应的 。
第一步:计算 与各个 的内积(相似度标量)。
这是一个行向量乘以列向量,结果是一个标量:
第二步:用标量加权对应的 。
将上一步得到的相似度(标量)直接乘以对应的行向量 :
- 权值
- 权值
- 权值
第三步:求和得到最终结果。
将这三个加权后的行向量相加:
03向量右乘矩阵#
Shape
- 矩阵: (m, n)
- 向量: (n, 1)
- 结果: (m, 1)
代数意义: 矩阵列向量的线性组合
- 当我们计算 时,实际上是以向量 的各个元素作为权重,对矩阵 的各个列向量进行线性加权求和
采用“行列”的方式进行计算, 的每一列 在不同的计算轮次中都是与 进行计算。
- 总是和 相乘
3.1矩阵乘法: B 切分列向量#
矩阵 由 个 的列向量 组成,即:
当矩阵 乘以矩阵 时,实际上是矩阵 分别去右乘矩阵 的每一个列向量。结果矩阵 的各个列,正是这些独立乘法的结果:
结果矩阵 的第 列(即 ),是矩阵 的所有列向量的线性组合。
3.2矩阵右乘对角方阵#
效果: 对 A 的列进行缩放
简单推导:
- 向量右乘矩阵 -> 对矩阵的列进行线性组合 -> 向量的各个元素代表对矩阵各个列的加权
- 每一列中只有一个数值不为 0 -> 只对某一特定的列进行加权
04向量左乘矩阵#
Shape
- 向量: (1, m)
- 矩阵: (m, n)
- 结果: (1, n)
代数意义: 矩阵行向量的线性组合
- 当我们计算 时,是以行向量 的各个元素作为权重,对矩阵 的各个行向量进行线性加权求和。
采用“行列”的方式进行计算, 的每一行 在不同的计算轮次中都是与 进行计算。
- 总是和 相乘
4.1矩阵乘法: A 切分为行向量#
矩阵 由 个 的行向量 组成,即:
当矩阵 乘以矩阵 时,实际上是矩阵 的每一个行向量分别去左乘矩阵 。结果矩阵 的各个行,正是这些独立乘法的结果:
结果矩阵 的第 行(即 ),是矩阵 的所有行向量的线性组合
4.2矩阵左乘对角方阵#
效果: 对 A 的行进行缩放
简单推导:
- 向量左乘矩阵 -> 对矩阵的行进行线性组合 -> 向量的各个元素代表对矩阵各个行的加权
- 每一行中只有一个数值不为 0 -> 只对某一特定的行进行加权
05矩阵乘法#
TODO
06L1 范数#
The norm calculates the sum of the absolute values of all elements within a vector or matrix.
Calculation: For a weight vector with elements, the norm is defined as:
07L2 范数#
The norm calculates the standard Euclidean distance of the weight vector from the origin. It is the square root of the sum of the squared values of the elements.
Calculation: For the same weight vector , the norm is defined as:
7.1L_2 误差#
误差( Error,或基于 范数的误差)是一种用于衡量两个向量、矩阵或张量之间差异的标准指标。在几何意义上,它等价于多维空间中的欧几里得距离
给定一个真实值张量 和一个预测值(或近似值)张量 ,假设它们被展平为包含 个元素的向量。 误差的计算方式是将它们对应位置元素的差值进行平方,然后求和,最后对总和开平方根。其标准的数学公式表示为:
平方的特性:使得正负误差不会相互抵消,且由于平方项的存在,它会对较大的个别偏差施加极其严厉的惩罚(例如,差值为 2 的惩罚是 4,而差值为 10 的惩罚高达 100)。
08KL 散度#
KL Divergence calculates the expected excess surprise from using an approximation distribution instead of the true distribution.
Calculation: For two discrete probability distributions, (the true distribution) and (the approximated or predicted distribution), defined on the same probability space , the KL Divergence from to is defined as:
Mathematical Breakdown:
- represents the actual probability of an event occurring.
- represents the model's predicted probability of that same event .
- The ratio compares these probabilities. If they are identical, the ratio is 1, and the becomes 0, meaning there is zero divergence.
- We multiply the log value by to compute the expected value (the weighted average) across the entire true distribution.
8.1Application in ML#
While norms are typically used to penalize or prune network weights, KL Divergence is predominantly used to optimize network outputs that represent probabilities.
Knowledge Distillation
- When compressing a massive neural network (the "teacher") into a smaller network (the "student"), KL divergence is used as the loss function.
- The student model is trained to minimize the KL divergence between its output probability distribution () and the teacher's output probability distribution (), forcing the student to mimic the teacher's exact confidence levels across all classes.
Cross-Entropy Loss
- In standard classification tasks, minimizing the Cross-Entropy loss is mathematically equivalent to minimizing the KL Divergence between the training data's one-hot encoded labels () and the model's softmax predictions ().
8.2Calculation Example#
Vector (The True Distribution): This represents the actual, ground-truth probabilities.
Vector (The Predicted Distribution): This represents what our neural network predicts the probabilities are.
Element 1:
Element 2:
Element 3:
Element 4:
Finally, we sum these individual components together:
09ML#
9.1Linear#
nn.Linear(in_features=m, out_features=n)
如果输入向量 的形状是 ,你想得到一个形状为 的输出 ,逻辑上最自然的权重矩阵 形状就应该是 。此时公式就是完美的
在 PyTorch 中,当我们实例化一个标准的线性层 nn.Linear(in_features=m, out_features=n) 时,它在底层初始化的权重矩阵 (即 layer.weight)的形状并不是 ,而是 。
所以为了方便理解,公式可以写为
因为 PyTorch 底层按照 row-major 的顺序在连续的内存空间中存储多维数组
- 如果按逻辑形态存为 ,计算第 个神经元时就需要跨步(Stride)去读取矩阵的第 列,这会导致非连续的访存跳跃,严重拖慢计算速度
- 如果物理权重存储为 ,那么这矩阵的第 行刚好包含了这 个所需的权重,且它们在物理内存中是完全连续的
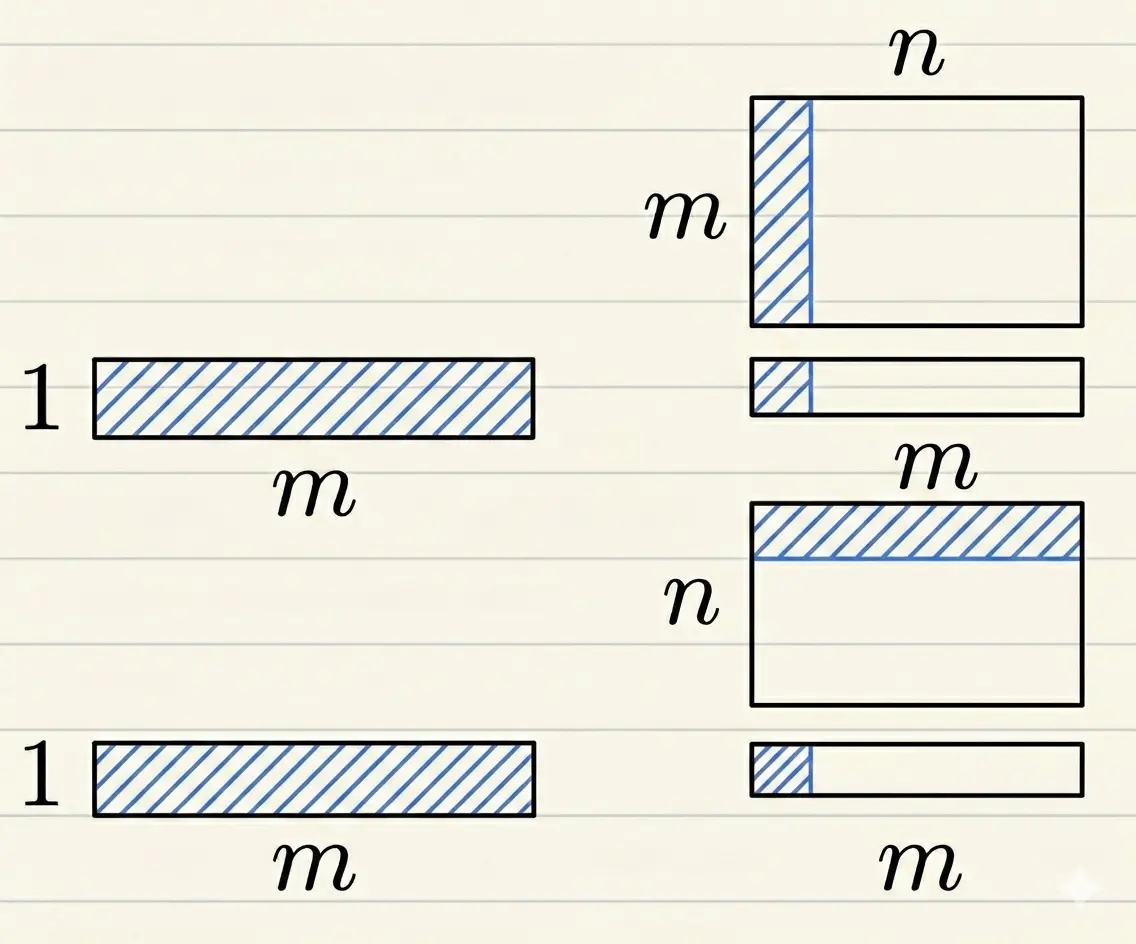
在传统的线性代数中,数据点默认被定义为列向量 (m, 1),为了让结果为 (n, 1), W 的 shape 就应该为 (n, m)
在深度学习时代,多条数据被习惯性地按照行堆叠存放,每个数据变为了行向量: (1, m)
- 将 的两边同时转置,就得到了 。这也是
- x: (1, m)
- : (m, n)