Deja Vu Contextual Sparsity for Efficient LLMs at Inference Time
- Doc no.
- KKZ-TN-089
- Date
- 2025-08-04
- GMT day
- 2025:216
- Est. read
- 6 min
Intensive Reading
01Author Info#
- Zichang Liu:Research Scientist at Meta.
- Jue Wang, Ph.D: Founder & President of Stylar AI (stylar.ai).
- Tri Dao: Assistant Professor of Computer Science at Princeton University. Chief Scientist at Together AI.
02Background#
2.1LLM Inference Latency Breakdown#
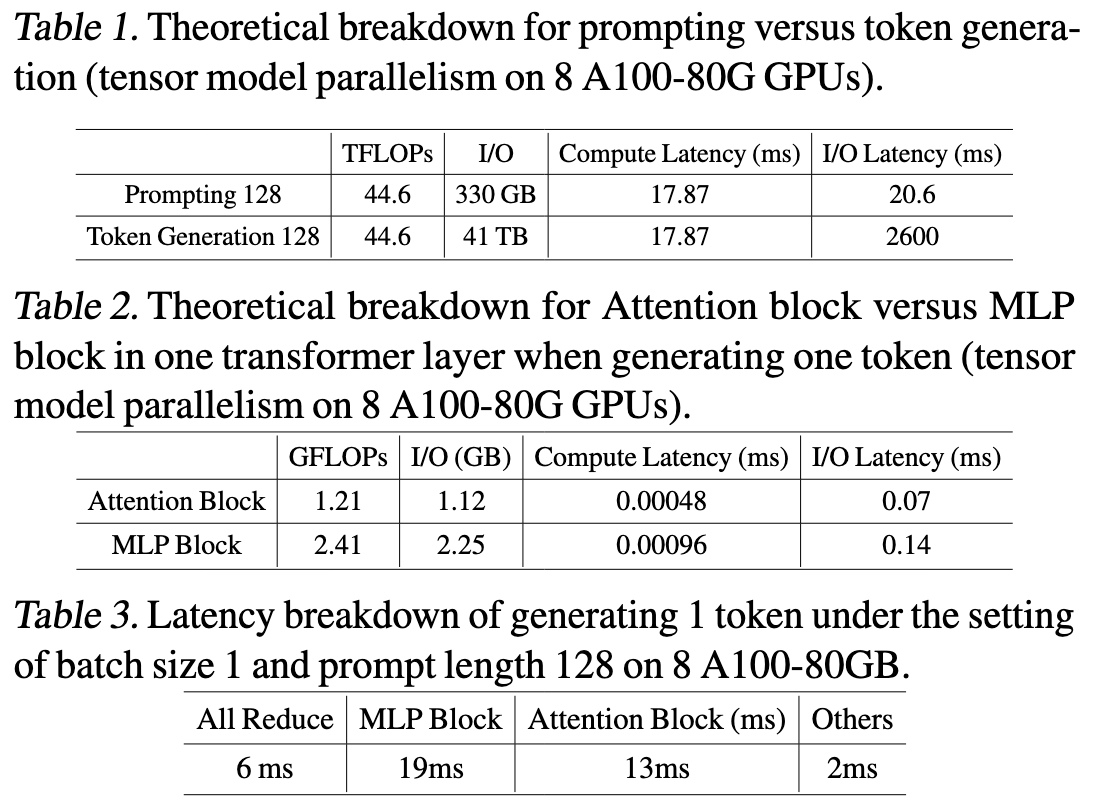
03Challenges#
Speeding up inference-time sparse LLMs in wall-clock time while maintaining quality and in-context learning abilities remains a challenging problem.
While sparsity and pruning have been well-studied, they have not seen wide adoption on LLMs due to the poor quality and efficiency trade-offs on modern hardware such as GPUs:
- It is infeasible to retrain or iteratively prune models at the scale of hundreds of billions of parameters.
- It is challenging to find sparsity that preserves the in-context learning ability of LLMs.
- It is hard to achieve wall-clock time speed-up with unstructured sparsity due to its well-known difficulty with modern hardware.
04Insights#
This paper envisions contextual sparsity, which are small, input-dependent sets of attention heads and MLP parameters that lead to (approximately) the same output as the full model for an input.
Contextual sparsity can be used for inference optimization due to the significant reduction of Memory I/O.
There are three related challenges:
- How to verify its existence?
- How to predict the sparsity for a given input in advance?
- How to achieve end-to-end wall-clock time speedup?
05Approaches#
5.1Pre-trained LLMs are Contextually Sparse#
这部分可以总结为三个 observations:
- Contextual sparsity exists.
- Token embeddings naturally form clusters after multi-layer processing, leading to a sparse distribution of attention scores.
- Activations are slowly changing across layers.
论文通过一个简单的“双通道”实验验证了其存在性。首先,在第一次前向传播中,记录下对于给定输入,哪些注意力头和MLP神经元的输出范数较大,即哪些是“活跃”的。然后在第二次前向传播时,只使用这些被记录下来的“活跃”参数进行计算。实验发现,仅使用这一小部分参数,模型的性能与使用完整模型几乎没有差异。
平均而言,可以对注意力头施加高达 80% 的稀疏度,对 MLP 神经元施加高达 95% 的稀疏度。综合起来,对于一个给定的输入,总的结构化稀疏度约为 85%。这证明了巨大的、可被利用的冗余是存在的。
MLP blocks 的上下文稀疏性很符合直觉,但注意力模块也存在这种特性,论文对此进行了深入研究。
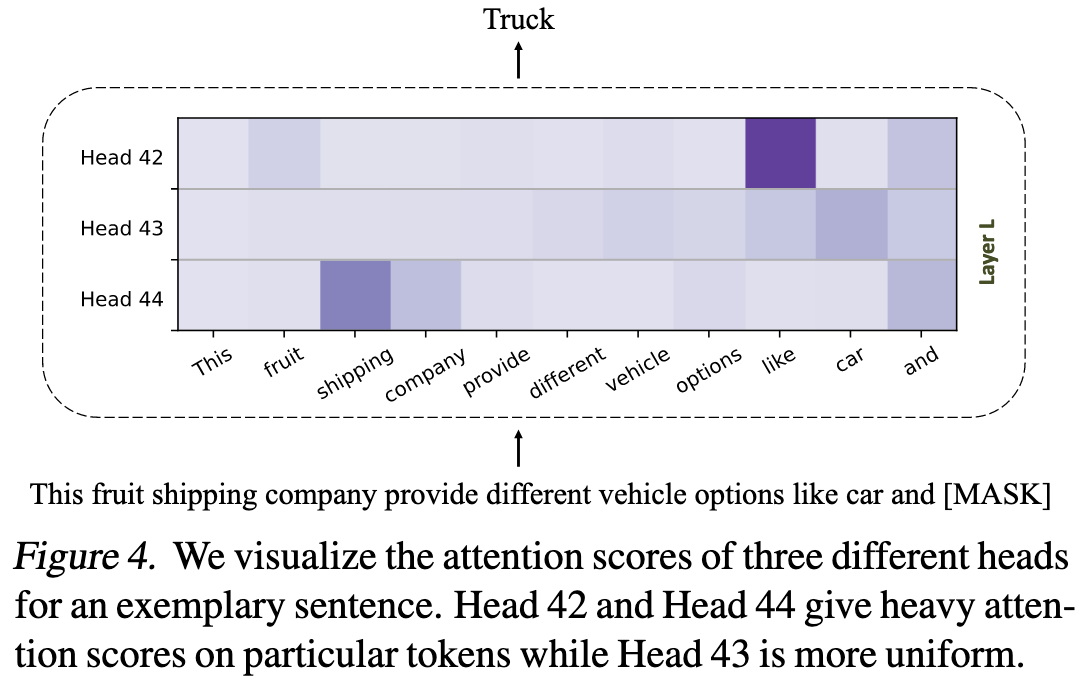
论文发现注意力头可以分为两类:
- Heavy hitter heads: 这些头的注意力会高度集中在少数几个关键的输入词元上
- Uniform heads: 这些头的注意力分数则相对均匀地分布在所有词元上
只保留“重磅头”而去掉“均匀头”并不会影响模型的预测结果。
作者提出了一个核心假说:自注意力机制本质上是在执行一步“均值漂移聚类”算法。
- 均值漂移聚类的思想是不断将数据点移动到其邻近点的均值位置,最终收敛到数据密度的中心。
- 在自注意力中,一个词元的新嵌入向量,是其在所有历史词元上的加权平均。这个“权重”(即注意力分数)由查询向量和键向量的相似度决定。作者证明,这个更新过程的数学形式与均值漂移聚类的一次迭代非常相似。
- 因此,每一层自注意力实际上都在将语义上相似的词元在某个投影空间中拉得更近(即“聚类”)。不同的注意力头学习不同的投影空间,从而执行不同的聚类任务。这种动态解释了为何令牌嵌入经过多层处理后会自然地形成簇,从而导致注意力分数呈现稀疏分布。
由于 Transformer 结构中残差连接的存在,模型在连续层之间的激活向量变化非常缓慢,其方向(余弦相似度)非常高,通常在 0.99 左右。
5.2DEJAVU#
DEJAVU 系统也可以分为三个部分:
- 如何预测上下文稀疏性
- 如何减少预测开销
- 如何利用上下文稀疏性来加速推理
论文选择训练一个非常小的、两层的全连接神经网络作为 Sparsity Predictor. 这个预测器以当前层的输入为依据,来预测下一层中哪些 MLP 神经元或注意力头将被激活。
在预测注意力时,可能会出现一种情况:假设有一个头 h,它在 t 时刻是非活跃的(h ∉ S_t),但在 t+1 时刻变成了活跃的(h ∈ S_{t+1})。根据注意力机制,头 h 在 t+1 时刻需要与包括 t 时刻在内的所有历史词元进行计算。但由于它在 t 时刻被跳过了,其对应的 K 和 V 向量从未被计算和存储。
DEJAVU 采用了按需计算的机制:每次都将输入 y 的副本保存起来,K 和 V 向量完全是输入 y 经过特定权重矩阵线性变换后的结果,发现缺少时直接计算即可。
DEJAVU 设计了一种异步查找预测机制:当计算第 k 层的注意力(Attention)时,系统可以 并行地 使用第 k 层注意力模块的输入去预测第 k 层MLP模块的稀疏模式,以及第 k+1 层注意力模块的稀疏模式。因为相邻层的输入高度相似,用前一层的输入来预测后一层的稀疏模式依然足够准确,从而完美隐藏了预测带来的延迟。
为了利用上下文稀疏性来加速推理,DEJAVU 采用了两种技术:
- Kernel Fusion: 使用 Triton 等工具编写了自定义的 GPU 核,将“索引稀疏参数”和“进行矩阵乘法”这两个步骤融合成一个单一操作。
- Memory Coalescing: 为了确保在读取稀疏的权重矩阵列时也能保持高效,DEJAVU 对部分权重矩阵(如 MLP 的第二层线性层和注意力头的输出投影矩阵)的存储格式进行了优化(改为列主序),确保内存访问是连续的,从而最大化利用 GPU 的内存带宽。
要理解内存合并技术,需要理解 MLP 层的计算,可以参考这里的解释。
W_up 的第 列和 W_down 的第 行是联系在一起的。
在存储 MLP 的两个权重矩阵时,如果都采用同一种矩阵存储格式(行主序或者列主序),对于稠密计算没有影响,但是对于稀疏计算,需要先通过索引读取分散的列时,如果是在行主序中取列和在列主序中取行都会导致非合并内存访问,性能急剧下降。
个人觉得这个改变存储格式的方法没有 LLM-Flash 中 "col-row bundling" 优雅和实用。
06Evaluation#
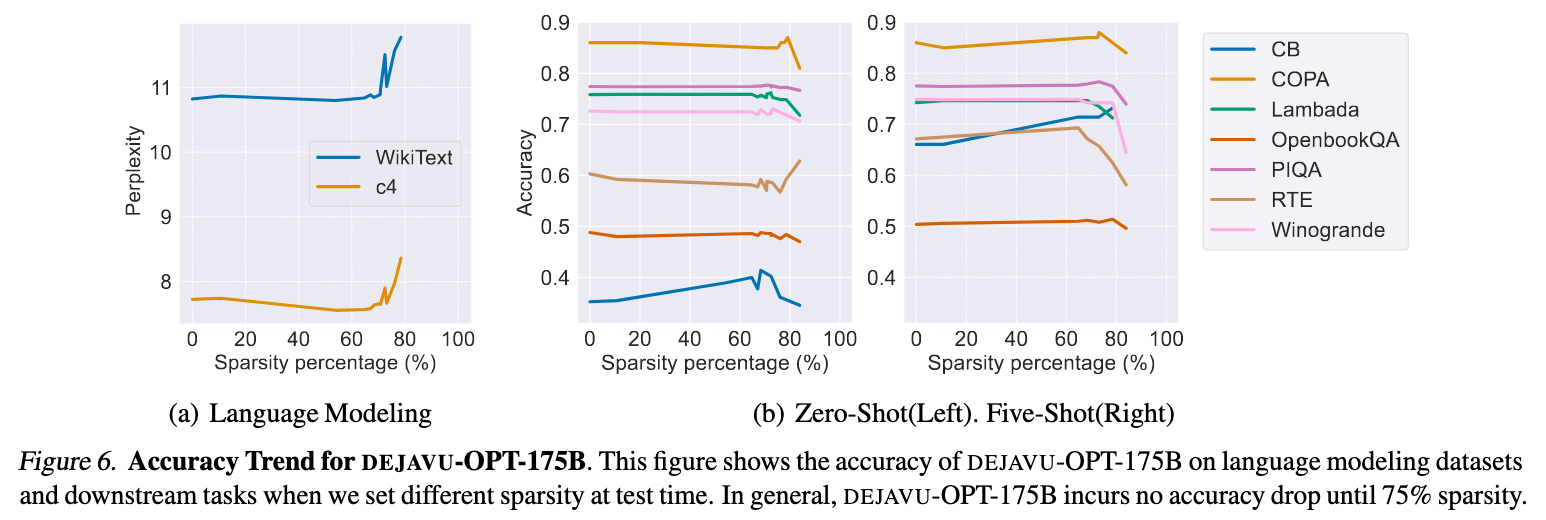
在语言建模(WikiText, C4)和七个下游的零样本/五样本(Zero-Shot/Five-Shot)任务中,DEJAVU 可以在高达 75% 的稀疏度下,几乎不造成任何准确率下降 。
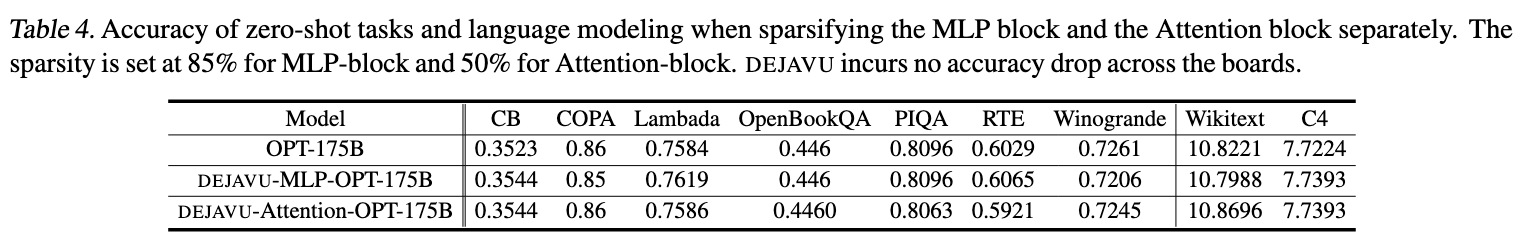
消融实验设置:
- 只对 MLP 模块应用稀疏化(85%稀疏度),Attention 模块保持密集。
- 只对 Attention 模块应用稀疏化(50%稀疏度),MLP 模块保持密集。
- 实验发现(表 4):在这两种独立的稀疏化设置下,模型在所有零样本任务和语言建模任务上的准确率均没有出现下降 。
结果分析:
- 这组实验有力地证明了 DEJAVU 的 模块化有效性。它表明,为 MLP 设计的稀疏预测器和为 Attention 设计的稀疏预测器都是独立且成功的。
- 这也验证了论文第三部分的核心洞察:上下文稀疏性在 MLP 层(因ReLU等激活函数)和 Attention 层(因令牌聚类效应)中是独立存在的。DEJAVU 成功地分别捕捉并利用了这两种不同来源的稀疏性。
07Thoughts#
7.1When Reading#
contextual sparsity 能不能和 speculative encoding 联系起来?